 https://agahiya.ir/اگر امروز از شما بپرسند هوش مصنوعی چیست، اولین تصویری که در ذهنتان شکل میگیرد چیست؟ رباتی انساننما که پشت میز مینشیند و مثل ما فکر میکند؟ واقعیت این است که هوش مصنوعی هیچ ربطی به آن تصویر هالیوودی ندارد. در سادهترین تعریف، هوش مصنوعی مجموعهای از روشهای ریاضی و الگوریتمی است که به ماشین اجازه میدهد از دادهها الگو یاد بگیرد و برای موقعیتهایی که صریحاً برایش برنامهنویسی نشدهاند، پیشبینی یا تصمیم تولید کند. یعنی بهجای آنکه برنامهنویس قانون «اگر مشتری اینطور بود، آنطور کن» را بنویسد، ماشین خودش قانون را از دل داده کشف میکند.
اهمیت این موضوع از آنجا میآید که هوش مصنوعی دیگر یک پروژه آزمایشگاهی نیست. وقتی چتجیپیتی در حدود دو ماه به بیش از صد میلیون کاربر فعال رسید — رقمی که شبکههای اجتماعی بزرگ سالها برای رسیدن به آن زمان صرف کردند — مشخص شد این فناوری از مرحله «جذابیت تکنولوژیک» عبور کرده و وارد زندگی روزمره شده است. گزارشهای سالانه مؤسسات مشاورهای مانند مککینزی هم نشان میدهد بخش بزرگی از سازمانهای متوسط و بزرگ امروز دستکم در یک فرایند از هوش مصنوعی استفاده میکنند؛ از پاسخگویی خودکار به مشتری تا پیشبینی تقاضا و تشخیص تقلب.
در این مقاله قرار نیست با اصطلاحات پیچیده ریاضی شما را خسته کنم. مسیر ما این است: ابتدا میفهمیم هوش مصنوعی دقیقاً چطور یاد میگیرد، سپس انواعش را از هم تفکیک میکنیم، کاربردهای اثباتشدهاش را در صنایع مختلف میبینیم، به محدودیتها و ریسکهای اخلاقیاش نگاه میکنیم و در پایان یک نقشه راه عملی برای پیادهسازی آن ترسیم میکنیم.
تجربه شخصی من با هوش مصنوعی سالها پیش و با یک مدل ساده پیشبینی فروش شروع شد که فاجعهبار عمل کرد؛ نه چون مدل بد بود، چون دادههای ورودیاش کیفیت نداشت. همان شکست اولین درس بزرگ من شد: در هوش مصنوعی، کیفیت داده مهمتر از پیچیدگی مدل است. در ادامه این ماجرا را مفصلتر باز میکنم.
هوش مصنوعی چگونه یاد میگیرد؟
از قانوننویسی دستی تا کشف الگو از داده
تفاوت بنیادین هوش مصنوعی با نرمافزار سنتی در جایگاه «منطق» است. در نرمافزار سنتی، منطق را انسان مینویسد و داده فقط ورودی است. در یادگیری ماشین، این رابطه برعکس میشود: شما داده و پاسخ درست را در اختیار الگوریتم میگذارید و او خودش قاعده را استخراج میکند. مثلاً برای تشخیص ایمیل تبلیغاتی، کسی قانون نمینویسد؛ هزاران ایمیل برچسبخورده به مدل داده میشود و مدل الگوهای زبانی و ساختاری هر دسته را یاد میگیرد.
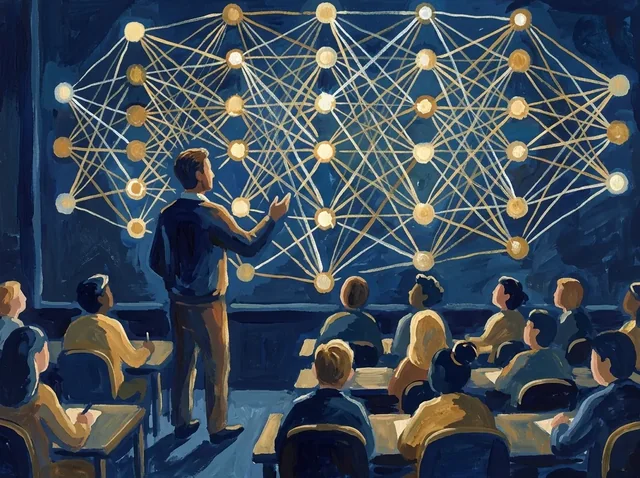
یادگیری عمیق نسخه پیشرفتهتر همین ایده است. در این روش، شبکههای عصبی با میلیاردها پارامتر، داده را لایهبهلایه پردازش میکنند: لایههای اولیه ویژگیهای ساده (لبه، صدا، حرف) و لایههای بالاتر مفاهیم پیچیده (چهره، کلمه، معنا) را میآموزند. همین ساختار است که مدلهای زبانی بزرگ را قادر میکند جمله بعدی را پیشبینی کنند و از دل این پیشبینی ساده، چیزی شبیه استدلال زبانی بیرون بیاید.
نکتهای که اغلب نادیده گرفته میشود این است که مدل هیچ «درکی» از واقعیت ندارد؛ او تنها در فضای آماری دادهای که دیده حرکت میکند. به همین دلیل است که یک مدل میتواند با اعتمادبهنفس کامل عددی اشتباه تولید کند. درک این محدودیت، پیشنیاز استفاده حرفهای از هوش مصنوعی است.
انواع هوش مصنوعی و تفاوت آنها
دستهبندی بر اساس توانایی و بر اساس کارکرد
معمولاً هوش مصنوعی را از دو زاویه دستهبندی میکنند. زاویه اول سطح توانایی است: هوش مصنوعی محدود (Narrow AI) که فقط یک وظیفه مشخص را انجام میدهد و تمام محصولات امروزی در این دستهاند؛ هوش مصنوعی عمومی (AGI) که هنوز وجود ندارد؛ و ابرهوش که صرفاً یک مفهوم نظری است. زاویه دوم، کارکرد فنی است که در جدول زیر مقایسه شده است.
| نوع | نحوه یادگیری | نمونه کاربرد | نیاز داده |
|---|---|---|---|
| یادگیری نظارتشده | با داده برچسبدار | تشخیص کلاهبرداری بانکی | زیاد، اما با کیفیت |
| یادگیری بدون نظارت | بدون برچسب، کشف الگو | دستهبندی مشتریان | زیاد، بدون برچسب |
| یادگیری تقویتی | پاداش و تنبیه | رباتیک و بهینهسازی | محیط شبیهسازیشده |
| هوش مصنوعی مولد | پیشبینی توزیع داده | تولید متن، تصویر، کد | بسیار زیاد |
انتخاب نوع درست، مستقیماً روی هزینه و نتیجه اثر میگذارد. بسیاری از تیمها بهاشتباه سراغ مدلهای مولد میروند، در حالی که مسئلهشان با یک مدل طبقهبندی ساده و ارزانتر حل میشود.
کاربردهای واقعی هوش مصنوعی در صنایع
از تشخیص پزشکی تا پشتیبانی مشتری
هوش مصنوعی وقتی ارزش واقعی میسازد که در دل یک فرایند مشخص بنشیند، نه وقتی بهعنوان یک برچسب تبلیغاتی روی محصول میچسبد. نمونههای زیر از موفقترین کاربردهای اثباتشده هستند:
- سلامت: تحلیل تصاویر رادیولوژی برای تشخیص زودهنگام ضایعات، با دقتی قابل مقایسه با متخصص و سرعتی بسیار بیشتر در غربالگری انبوه.
- بانکداری: امتیازدهی اعتباری و کشف تراکنشهای مشکوک در کسری از ثانیه، که سالانه میلیاردها تومان ضرر را مهار میکند.
- خردهفروشی: پیشبینی تقاضا برای موجودی انبار و قیمتگذاری پویا بر اساس الگوی خرید.
- پشتیبانی مشتری: دستیارهای مکالمهای که تا ۶۰ درصد تیکتهای تکراری را بدون دخالت انسان پاسخ میدهند.
- تولید: نگهداری پیشبینیکننده بر اساس داده سنسورها، پیش از آنکه دستگاه واقعاً خراب شود.
وجه مشترک همه این مثالها یک چیز است: وجود داده تاریخی قابل اتکا و معیار موفقیت روشن. جایی که این دو نباشند، هوش مصنوعی هم معجزه نمیکند.
مزایا و محدودیتهای واقعی هوش مصنوعی
مرز میان انتظار و واقعیت
بزرگترین خطر در adopted هوش مصنوعی، انتظارات غیرواقعی است. مدل زبانی ابزار قدرتمندی برای تولید پیشنویس، خلاصهسازی و بازنویسی است، اما جای تصمیمگیری نهایی انسانی را نمیگیرد. مزیت اصلی آن سرعت و مقیاس است؛ محدودیت اصلی آن فقدان درک زمینه، حساسیت به کیفیت داده و هزینه محاسباتی.
- مزیت: خودکارسازی کارهای تکراری و آزاد کردن زمان برای کارهای خلاقانه.
- مزیت: کشف الگوهایی که چشم انسان در حجم بالای داده نمیبیند.
- محدودیت: شکنندگی در برابر دادههای خارج از توزیع آموزشی.
- محدودیت: دشواری توضیحپذیری تصمیم در مدلهای پیچیده.
- محدودیت: هزینه زیرساخت و نیاز به تخصص نگهداری.
یک قاعده عملی که همیشه به تیمها میگویم: اگر نمیتوانید معیار موفقیت را در یک جمله بنویسید، هنوز آماده شروع نیستید.
چالشهای اخلاقی، حریم خصوصی و توهمزایی
مسئولیتی که به مدل نمیتوان سپرد
هوش مصنوعی از دادههای انسانی یاد میگیرد و بنابراین سوگیریهای انسانی را هم بازتولید میکند. اگر دادههای استخدامی گذشته به گروهی خاصadvantage داده باشد، مدل هم همان را تکرار میکند و این بار با ظاهری بیطرف و علمی. این پدیده «سوگیری الگوریتمی» نام دارد و در حوزههایی مثل بیمه، وام و منابع انسانی پیامدهای حقوقی جدی دارد.
مسئله دوم، توهمزایی یا hallucination است: مدل زبانی گاهی اطلاعاتی میسازد که کاملاً غلط است اما بسیار باورپذیر بیان میشود. راهحل عملی، اتصال مدل به منابع دانش قابل ارجاع (RAG) و الزام به ذکر منبع است، نه اعتماد کورکورانه. مسئله سوم حریم خصوصی است؛ دادههای حساس سازمانی نباید بدون قرارداد و کنترل، وارد سرویسهای عمومی شوند. هر سازمانی که با هوش مصنوعی کار میکند، به یک سیاست مکتوب درباره داده، بازبینی انسانی و پاسخگویی نیاز دارد.
نقشه راه پیادهسازی هوش مصنوعی در کسبوکار
شروع کوچک، اندازهگیری دقیق، گسترش تدریجی
موفقترین پروژههای هوش مصنوعی که دیدهام، همگی یک الگوی مشترک داشتهاند: شروع از یک مسئله دردناک و مشخص، نه از یک فناوری جذاب. مسیر پیشنهادی من این است: ابتدا فرایند را دقیق ترسیم کنید و هزینه فعلی آن را بسنجید؛ سپس بررسی کنید آیا داده کافی و قابل دسترسی وجود دارد؛ بعد یک نمونه اولیه کوچک بسازید و آن را در برابر معیار پایه (baseline) بسنجید؛ و تنها در صورت اثبات ارزش، آن را به تولید ببرید.
یک اشتباه رایج، خرید پلتفرم گران پیش از تعریف مسئله است. تجربه نشان داده تیمی که با یک اسکریپت ساده و داده تمیز شروع میکند، اغلب سریعتر از تیمی به نتیجه میرسد که با ابزارهای گرانقیمت و بدون فرضیه روشن کار را آغاز کرده است. آموزش نیروی انسانی و طراحی فرایند بازبینی انسانی هم بخشی از پیادهسازی است، نه کاری جانبی.
آنچه در عمل آموختم
روایتی از یک شکست پرهزینه
چند سال پیش روی پروژهای کار میکردم که هدفش پیشبینی میزان فروش هفتگی یک فروشگاه زنجیرهای بود. تیم ما با هیجان سراغ یک مدل شبکه عصبی عمیق رفتیم، دو ماه روی معماری و تنظیم ابرپارامترها وقت گذاشتیم و در نهایت مدلی ساختیم که روی داده تست عملکرد متوسطی داشت. اما در دنیای واقعی فاجعه بود؛ پیشبینیها با واقعیت فاصله زیادی داشتند و مدیرعامل پروژه را متوقف کرد.
وقتی برگشتیم و داده را کالبدشکافی کردیم، فهمیدیم مشکل جای دیگری بود: چند شعبه دادههایشان را با فرمت متفاوت ثبت میکردند، تعدادی رکورد تکراری وجود داشت و تعطیلات محلی در داده لحاظ نشده بود. همان مدل ساده رگرسیونی که ابتدا تحقیرش کرده بودیم، بعد از پاکسازی داده از مدل پیچیده ما بهتر عمل کرد. درس من این بود: هفتاد درصد زمان پروژه باید صرف داده و تعریف مسئله شود، نه مدل. از آن به بعد همیشه قبل از هر خط کد، یک جلسه «تعریف معیار موفقیت» با ذینفعان برگزار میکنم و نسخه پایه ساده را اول میسازم.
سوالات متداول
آیا هوش مصنوعی جای شغل انسانها را میگیرد؟
پاسخ ساده «بله» یا «خیر» گمراهکننده است. آنچه واقعاً رخ میدهد، تغییر ترکیب مشاغل است نه حذف کلی آنها. کارهای تکراری و قاعدهمحور بیشترین احتمال خودکارسازی را دارند، در حالی که مهارتهای مرتبط با قضاوت، مذاکره، خلاقیت و مسئولیتپذیری ارزش بیشتری پیدا میکنند. تاریخ فناوری هم نشان داده هر موج خودکارسازی، مشاغل جدیدی ساخته است. مهمترین اقدام عملی برای هر فرد، یادگیری کار کردن با این ابزارها و تمرکز بر مهارتهایی است که ماشین در آنها ضعیف است.
تفاوت هوش مصنوعی و یادگیری ماشین چیست؟
هوش مصنوعی یک حوزه گسترده و چتر مفهومی است که هدفش ساختن سیستمهایی با رفتار هوشمند است. یادگیری ماشین یکی از زیرشاخههای این حوزه است که به روشهای یادگیری از داده میپردازد. یادگیری عمیق هم زیرمجموعه یادگیری ماشین است و از شبکههای عصبی چندلایه استفاده میکند. به بیان دیگر، هر یادگیری ماشینی هوش مصنوعی هست، اما هر سیستم هوش مصنوعی لزوماً از یادگیری ماشین استفاده نمیکند؛ مثلاً سیستمهای خبره قدیمی مبتنی بر قواعد دستی بودند.
برای شروع هوش مصنوعی در یک کسبوکار کوچک از کجا آغاز کنیم؟
از یک فرایند پرتکرار و پرهزینه شروع کنید که دادهاش را در دست دارید؛ مثلاً پاسخگویی به سوالات تکراری مشتریان یا تهیه پیشنویس پیشنهاد قیمت. ابزارهای آماده امروز برای شروع نیازی به تیم مهندسی بزرگ ندارند. یک آزمایش کوچک و محدود طراحی کنید، نتیجه را با وضعیت فعلی مقایسه کنید و فقط در صورت بهبود قابل اندازهگیری، سرمایهگذاری بیشتری انجام دهید. مستندسازی فرایند و آموزش کارکنان را از روز اول جدی بگیرید.
آیا دادههای ما در ابزارهای هوش مصنوعی عمومی امن است؟
بستگی به سرویس و تنظیمات آن دارد و نمیتوان یک پاسخ کلی داد. بسیاری از سرویسهای تجاری تعهد قراردادی برای عدم استفاده از داده مشتری در آموزش مدل ارائه میکنند، اما نسخههای رایگان معمولاً چنین تضمینی ندارند. پیش از هر استفاده، سیاست داده را مطالعه کنید، اطلاعات هویتی و محرمانه را حذف یا ماسک کنید و برای دادههای حساس سراغ راهکارهای درونسازمانی بروید. تدوین یک دستورالعمل داخلی ساده، بیشترین ریسک را دفع میکند.
نتیجهگیری
هوش مصنوعی یک جادو نیست؛ یک ابزار آماری قدرتمند است که کیفیت خروجیاش مستقیماً به کیفیت داده، شفافیت مسئله و میزان نظارت انسانی وابسته است. در این مقاله دیدیم که مدلها چگونه از داده الگو میآموزند، انواع مختلف یادگیری چه کاربردی دارند، کدام صنایع بیشترین ارزش را از آن گرفتهاند و چه محدودیتهایی مانند سوگیری، توهمزایی و حریم خصوصی باید جدی گرفته شوند. مهمترین درس عملی هم ساده بود: مسئله را قبل از فناوری تعریف کنید، با نسخه پایه شروع کنید و داده را جدی بگیرید. سازمانهایی که این ترتیب را رعایت میکنند، معمولاً نتایج پایدارتری میگیرند.
اگر تا اینجا همراه بودهاید، وقت آن است که از دانش به عمل برسید. یک فرایند در کار خود انتخاب کنید که هر هفته زمان زیادی از شما میگیرد و دادهاش را در دسترس دارید. همان را به یک آزمایش کوچک یکماهه تبدیل کنید و نتیجه را اندازه بگیرید. برای شروع، میتوانید چکلیست آمادگی سازمان برای هوش مصنوعی را دانلود کنید و مسیر را گامبهگام پیش ببرید. تفاوت بزرگ میان کسانی که از این موج عقب میمانند و کسانی که سوار آن میشوند، معمولاً همین یک قدم کوچک اول است.
درباره نویسنده: این محتوا بر پایه بیش از پانزده سال تجربه در استراتژی محتوا و مدیریت پروژههای دادهمحور، همراه با مطالعه گزارشهای سالانه مؤسسات پژوهشی معتبر و تجربه عملی پیادهسازی مدلهای یادگیری ماشین در تیمهای محصول تدوین شده است.
💬 نظرات (0)
هنوز نظری ثبت نشده.